
Stellen Sie einen MLOps-Engineer ein, sobald Ihr Team aus mehreren ML-Engineers besteht oder mehrere Modelle produktiv laufen haben. Liegt Ihr Unternehmen darunter, reicht ein bestehendes DevOps-Team mit ML-Grundwissen oder ein Managed Service völlig aus. Alles Weitere in diesem Artikel dreht sich um die Kriterien, Rollenprofile und Organisationsmodelle, die diese Faustregel im Alltag konkret machen.
Kurz gesagt:
- Sobald im Team mehr als zwei ML-Engineers oder drei Modelle in Produktion sind, ist die Einstellung eines dedizierten MLOps-Engineers notwendig.
- Ein MLOps-Team überwacht statistische Modellgüte und automatisiertes Retraining, während DevOps primär Anwendungscode und Systemstabilität kontrolliert.
- Dezentrale Modellownership ist bei wenigen Modellen sinnvoll, doch ab fünf+ Modellen und strenger Compliance ist eine zentrale Plattform vorzuziehen.
- Praktische Einstellkriterien sind die Anzahl der Alarmmeldungen pro Woche sowie die Incident-Erfahrung der Kandidaten im produktiven Betrieb.
- Bei geringer Modellanzahl reicht meist ein erfahrener ML Engineer oder Managed Service, erst bei mehreren Modellen wird interne Infrastruktur und spezialisierte Fachkraft notwendig.
Inhaltsverzeichnis
- MLOps vs. DevOps: Wo unterscheiden sich die Verantwortlichkeiten?
- Wer wird zuerst eingestellt: ML Engineer oder MLOps Engineer?
- Zentrale MLOps-Plattform oder verteilte Modell-Ownership?
- Welche Skills sollten Sie im Interview prüfen?
- Warum menschliche Einschätzung bei MLOps-Rollen entscheidet
- So unterstützt Polydigital Ihre MLOps-Entscheidung
- Quellen
- FAQ
MLOps vs. DevOps: Wo unterscheiden sich die Verantwortlichkeiten?
DevOps verwaltet Code. MLOps verwaltet Code, Daten und Modelle gleichzeitig, und genau diese dritte Dimension verändert das Anforderungsprofil komplett. Ein DevOps-Team kümmert sich um Versionierung, Continuous Integration und Deployment einer Anwendung, deren Verhalten deterministisch ist. Ein Bug bleibt ein Bug, bis er behoben ist. MLOps arbeitet dagegen mit Systemen, deren Qualität sich über Zeit verändert, ohne dass jemand eine Zeile Code angefasst hat. Databricks beschreibt diesen Unterschied treffend: MLOps erweitert DevOps um Continuous Training und Drift-Monitoring, also um Prozesse, die es im klassischen Softwarebetrieb schlicht nicht gibt.
Für Recruiter heißt das konkret: Die Stellenbeschreibung eines MLOps-Engineers braucht andere Artefakte als die eines DevOps-Engineers.
- Deployment: DevOps deployt Anwendungscode; MLOps deployt Modellversionen inklusive Trainingsdaten-Snapshot und Feature-Pipeline.
- Monitoring: DevOps überwacht Verfügbarkeit und Latenz; MLOps überwacht zusätzlich statistische Modellgüte, etwa Genauigkeit auf neuen Daten.
- Drift-Erkennung: Ein rein technischer Fehlerfall existiert bei DevOps kaum. Bei MLOps ist die schleichende Verschlechterung der Vorhersagequalität der Normalfall, nicht die Ausnahme.
- Retraining: DevOps kennt Rollbacks auf eine ältere Codeversion. MLOps braucht zusätzlich automatisierte Neutrainings-Zyklen, wenn sich die Datengrundlage verschiebt.
- On-call: Ein DevOps-Incident ist meist binär (läuft oder läuft nicht). Ein MLOps-Incident kann bedeuten, dass das System läuft, aber falsche Entscheidungen trifft.
TechTarget bringt es auf den Punkt: Beide Disziplinen teilen sich das Fundament aus Automatisierung, Versionierung und CI/CD. Der Unterschied liegt im nicht deterministischen Verhalten von Modellen, das eine völlig neue Fehlerklasse erzeugt. Ein bestehender DevOps-Stack reicht so lange aus, wie Ihre Modelle selten aktualisiert werden und keine geschäftskritischen Entscheidungen automatisiert treffen. Sobald Retraining Routine wird, brauchen Sie Fachwissen, das speziell für diese Fehlerklasse ausgebildet ist.
Wer wird zuerst eingestellt: ML Engineer oder MLOps Engineer?
Die Reihenfolge folgt fast immer demselben Muster, unabhängig von Branche oder Unternehmensgröße.
- Proof of Concept: Ein einzelner Data Scientist oder ML Engineer reicht aus. Es gibt kein Produktionsrisiko, also auch keinen Bedarf für eine eigene Betriebsrolle.
- Erstes Produktionsmodell: Ein ML Engineer mit Deployment-Erfahrung übernimmt die Rolle mit, oft unterstützt durch einen vorhandenen DevOps-Engineer, der grundlegende ML-Konzepte versteht.
- Zweites bis drittes Modell: Hier kippt die Rechnung. Databricks nennt als generelle Empfehlung, dass ab einer gewissen Anzahl von ML-Engineers oder Produktionsmodellen ein dedizierter MLOps-Engineer sinnvoll werden kann.
- Skalierung über mehrere Teams: Sobald verschiedene Fachbereiche eigene Modelle betreiben, wird eine Plattform-Rolle relevant. Domino beschreibt den ML Platform Engineer als Rolle, die Wiederverwendbarkeit über Projektgrenzen hinweg sicherstellt, sobald mehrere Teams gleichzeitig skalieren.
- Data Engineer als Querschnittsrolle: Unabhängig vom Reifegrad brauchen Sie früh jemanden, der Datenpipelines robust hält. Ohne diese Basis scheitert jedes MLOps-Vorhaben an der Datenqualität, bevor es überhaupt beim Modell ankommt.
Eine praktische Kennzahl, die sich in der Praxis bewährt, ist die Anzahl der Alarme und On-call-Endpunkte pro Woche. KORE1 empfiehlt einen Blick auf die operative Belastung im On-call, da dies ein wichtiges Signal für den Bedarf an MLOps-Ressourcen sein kann. Wenn Ihr bestehendes Team wöchentlich mehrfach wegen Modellverhalten aus dem Schlaf gerissen wird, ist das ein deutlicheres Signal als jede Kopfzahl-Tabelle. Bei einem oder zwei Modellen lohnt sich eine dedizierte Rolle selten. Bündeln Sie die Aufgabe stattdessen bei einem bestehenden ML Engineer oder greifen Sie auf einen Managed Service zurück, bis das Volumen die Investition rechtfertigt.
Zentrale MLOps-Plattform oder verteilte Modell-Ownership?
Zwei Organisationsmodelle konkurrieren, sobald mehr als ein Team Modelle produktiv betreibt. Beide haben handfeste Vor- und Nachteile, die selten offen ausgesprochen werden.
Bei der zentralisierten Plattform betreibt ein spezialisiertes Team die gesamte Infrastruktur für Deployment, Monitoring und Retraining. Fachteams liefern Modelle, die Plattform übernimmt den Betrieb. Das reduziert Redundanz und schafft einheitliche Governance, verlangsamt aber Iterationszyklen, weil jedes neue Modell durch eine zentrale Warteschlange muss.
Bei der verteilten Ownership betreibt jedes Fachteam sein eigenes Modell inklusive Deployment und Monitoring. Das beschleunigt einzelne Teams erheblich, führt aber schnell zu inkonsistenten Sicherheitsstandards und doppelter Arbeit, wenn mehrere Teams dieselben Probleme unabhängig voneinander lösen.
Die Entscheidung hängt an drei Faktoren:
- Compliance-Anforderungen: Regulierte Branchen wie Finanzdienstleistungen oder Gesundheitswesen profitieren fast immer von zentraler Governance, weil Nachvollziehbarkeit sonst kaum durchsetzbar ist.
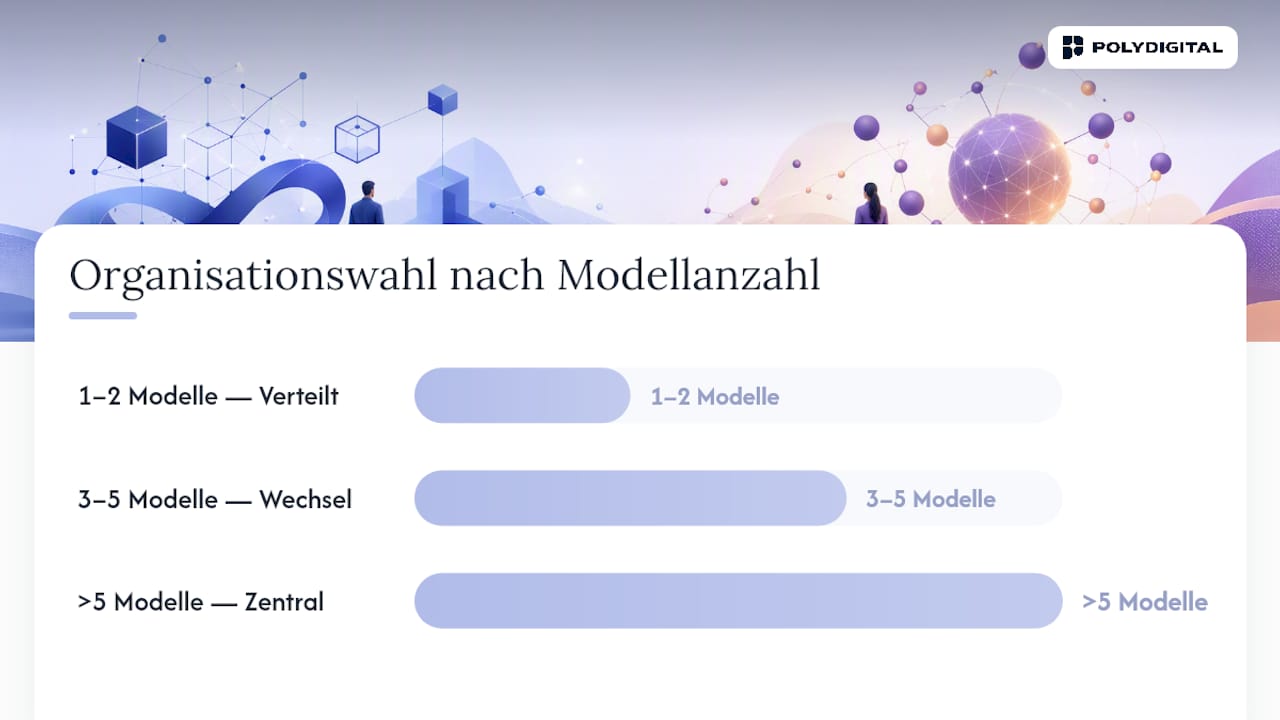
- Anzahl der Use Cases: Unter fünf Modellen lohnt sich eine eigene Plattform selten. Darüber steigt der Koordinationsaufwand verteilter Teams überproportional.
- Kostenstruktur: Eine zentrale Plattform bindet Fixkosten, verteilte Ownership verursacht variable, aber schwerer planbare Kosten pro Team.
Databricks weist darauf hin, dass hybride Produkte, bei denen Modelle neben regelbasierter Logik laufen, besonders koordinierte Pipelines und gemeinsame Review-Zyklen zwischen DevOps- und MLOps-Teams brauchen. Genau hier scheitern viele Organisationen, weil beide Teams parallel arbeiten, ohne gemeinsame Freigabeprozesse zu definieren.
Profi-Tipp: Starten Sie mit verteilter Ownership beim Proof of Concept und wechseln Sie erst bei drei bis fünf produktiven Modellen bewusst in eine zentrale Plattform. Der Wechsel zu früh kostet Tempo, der Wechsel zu spät kostet Kontrolle.
Welche Skills sollten Sie im Interview prüfen?
Tool-Namen sagen wenig über die tatsächliche Eignung eines Kandidaten aus. CODERCOPS betont, dass Produktionserfahrung und Incident-Handling deutlich aussagekräftiger sind als reine Checklisten aus Frameworks und Plattformen.
- Fragen Sie nach einem konkreten Produktions-Incident: Was ist passiert, wie wurde er erkannt, wie lange hat die Behebung gedauert?
- Lassen Sie ein Rollback-Szenario durchspielen: Ein Modell verschlechtert sich zwei Wochen nach Deployment. Was ist der erste Schritt?
- Prüfen Sie, ob der Kandidat CI/CD für Modelle von CI/CD für Code unterscheiden kann, inklusive Datenversionierung.
- Testaufgaben sollten reale Szenarien wie Drift-Erkennung simulieren, nicht bloß eine Tool-Installation abfragen.
- Rote Flagge: Der Kandidat nennt viele Tools, aber kein einziges konkretes Incident-Beispiel aus eigener Erfahrung.
- Rote Flagge: Keine Erfahrung mit tatsächlichen Produktions-Deployments, nur mit Notebooks und Experimenten.
Warum menschliche Einschätzung bei MLOps-Rollen entscheidet
Die Debatte um Tools und Frameworks lenkt oft von der eigentlichen Herausforderung ab: MLOps-Rollen verlangen eine andere Denkweise als klassische Softwareentwicklung, weil Fehler statistisch statt deterministisch auftreten. Ein DevOps-Engineer kann diese Aufgaben übergangsweise übernehmen, aber der Unterschied in der Fehlerklasse zeigt sich spätestens beim ersten Drift-Incident, der sich nicht wie ein klassischer Bug verhält.
Das Unternehmen besetzt Schnittstellenrollen im Kontext der KI-Transformation, von MLOps Engineer bis AI Governance Officer, und verfolgt dabei einen Ansatz, der die menschliche Bewertung ins Zentrum stellt statt reiner Tool-Kompatibilität. Ein Mandat löst typischerweise den Engpass, der entsteht, wenn ein Unternehmen technisch weiß, welche Rolle fehlt, aber weder Zeit noch Netzwerk hat, um die richtige Person mit echter Produktionserfahrung zu finden statt mit einer beeindruckenden Tool-Liste im Lebenslauf.
— Ingmar
So unterstützt Polydigital Ihre MLOps-Entscheidung
Ein internes Hiring-Verfahren für MLOps-Rollen dauert oft Monate, weil die Kombination aus Produktionserfahrung, statistischem Verständnis und Incident-Routine selten ist und sich kaum über Standard-Jobportale finden lässt. Als spezialisierter Personalpartner ist eine Alternative zum monatelangen Alleingang: statt selbst nach der Nadel im Heuhaufen zu suchen, erhalten Sie Zugriff auf einen geprüften Kandidatenpool, der bereits auf Produktionserfahrung statt Tool-Wissen selektiert wurde.
Das Angebot umfasst Rollenberatung, um zu klären, ob tatsächlich ein dedizierter MLOps-Engineer oder eher eine gebündelte Rolle gebraucht wird, dazu Direktansprache passender Fachkräfte und branchenspezifische Reports zu aktuellem Bedarf. Ein Mandat lohnt sich besonders dann, wenn internes Recruiting keinen Zugang zu Kandidaten mit echter Incident-Erfahrung hat oder wenn schnell entschieden werden muss, ob Managed Service oder Festanstellung die richtige Wahl ist. Wer diese Entscheidung nicht allein treffen möchte, findet auf der Website von Polydigital den direkten Einstieg in ein Erstgespräch.
Quellen
Vertiefende technische Details zu Pipelines und Tools finden Sie bei Databricks und Domino. Dieser Artikel fokussiert bewusst auf Hiring und Organisation, nicht auf Pipeline-Architektur.
- Databricks: MLOps vs DevOps
- Domino: 7 Roles In MLOps
- CODERCOPS: How to Hire an MLOps Engineer in 2026
- TechTarget: MLOps vs DevOps
FAQ
Was ist der Hauptunterschied zwischen MLOps und DevOps?
DevOps verwaltet Code und Deployment-Prozesse, MLOps zusätzlich Daten und Modelle inklusive Drift-Monitoring und Continuous Training. Diese dritte Dimension verlangt andere Fähigkeiten als klassischer Softwarebetrieb.
Ab wann brauche ich einen dedizierten MLOps-Engineer?
Als Faustregel gilt: ab zwei oder mehr ML-Engineers im Team oder ab drei oder mehr Modellen in Produktion. Darunter reicht meist ein bestehendes DevOps-Team oder ein Managed Service.
Ist ein ML-Engineer dasselbe wie ein MLOps-Engineer?
Nein. Der ML Engineer entwickelt und trainiert Modelle, der MLOps-Engineer verantwortet Deployment, Monitoring und Betrieb dieser Modelle in Produktion.
Wann lohnt sich ein Managed Service statt einer internen Rolle?
Bei einem oder zwei Produktionsmodellen ist ein Managed Service oder eine gebündelte Rolle meist wirtschaftlicher als ein dediziertes Team. Erst ab mehreren produktiven Modellen rechnet sich die interne Festanstellung.
Wie hilft Polydigital bei der Besetzung von MLOps-Rollen?
Polydigital identifiziert über Direktansprache und einen geprüften Kandidatenpool Fachkräfte mit echter Produktionserfahrung für MLOps- und angrenzende KI-Rollen, statt sich auf reine Tool-Kenntnisse zu verlassen.